يظهر الضغط على ذاكرة الخادم في صورة بطء و Swap مرتفع وأحيانًا خطأ 502، لكنه لا يعني تلقائيًا أن تطبيق Node.js يعاني تسرب ذاكرة. هذا الدليل يفرق بين ارتفاع الاستهلاك الطبيعي، وتكدس المهام، وتسرب الذاكرة الحقيقي، وقرارات OOM Killer، ثم يقدم خطة تشخيص وتخفيف تحافظ على بيانات العمل.
لماذا لا يعني ارتفاع RAM وجود Memory Leak؟
قد يرتفع استهلاك الذاكرة بسبب زيادة الطلبات أو تشغيل عشرات العمال أو التخزين المؤقت المشروع. تسرب الذاكرة يعني أن عناصر لم تعد مطلوبة لا تتحرر مع الزمن، ولذلك يستمر خط الأساس في الارتفاع بعد انتهاء الحمل. أما الزيادة المؤقتة فهي نمط طبيعي عند ارتفاع عدد العمليات ثم تهبط بعد انحساره. اسأل أولًا: هل ترتفع الذاكرة المستهلكة لكل عملية على حدة، أم أن عدد العمليات هو الذي يتضاعف؟ هذا الفرق يحدد ما إذا كنت ستفحص كود التطبيق أم نظام الجدولة.
توجد أيضًا ذاكرة يديرها نظام التشغيل للكاش؛ انخفاض قيمة free لا يعني وحده خطرًا إذا كانت قيمة available جيدة. انتبه إلى وحدات القياس: RSS يمثل الصفحات المقيمة من العملية ولا يساوي Heap المستخدم في JavaScript، بينما VIRT يعبر عن مساحة عناوين افتراضية أوسع. ضع هذه القيم في سياق عدد العمليات و swap ومعدل الأخطاء وزمن الاستجابة. لا تتخذ قرارًا بإيقاف الخدمة بسبب رسم واحد دون معرفة ما يقيسه.
كيف تكتشف ضغط التزامن بدل التسرب؟
احسب عدد العمليات المتشابهة مع العمر الزمني لكل واحدة. لو أطلقت مؤقتات المهام نسخة جديدة قبل انتهاء النسخة السابقة، فسيتزايد العدد تدريجيًا حتى لو كانت ذاكرة كل نسخة ثابتة. مثال تقريبي للتخطيط: أربعون عملية تستهلك كل منها 250 ميجابايت تقترب من 10 جيجابايت من الذاكرة المقيمة قبل حساب قاعدة البيانات والويب والنظام. هذا حساب تقديري وليس معيارًا؛ الواقع يتغير وفق مشاركة الصفحات والذاكرة المسجلة وطبيعة عبء العمل.
راجع سجل المهمة وسبب عدم انتهائها: هل تنتظر شبكة خارجية؟ هل انتهت المهلة في البرنامج الأب بينما بقي ابن منفصل يعمل؟ هل أنشأ نظام service وحدة transient لا تتوقف؟ ضع حدًا للتزامن وقفلًا مشتركًا بين كل طرق التشغيل، لا داخل نسخة واحدة فقط. والأفضل أن تقيس عدد المهام النشطة والمنتظرة والفاشلة بجانب استهلاك RAM، لأن زيادة الطابور قد تكون العلامة السابقة لانفجار العمليات.
متى يبدأ swap في الإضرار بالخدمة؟
ينقل Linux صفحات ذاكرة أقل استخدامًا إلى swap لتوفير مساحة للذاكرة النشطة. وجود استخدام محدود منه لا يعني خطرًا مباشرًا؛ الخطر يظهر عند تبادل كثيف للصفحات يترافق مع بطء I/O وارتفاع الانتظار وانخفاض الاستجابة. إذا راقبت kswapd واستهلاك swap وزمن قراءة القرص معًا، ستفهم هل النظام يحاول التعافي أم ينتقل إلى وضع ضغط مستمر. يجب عدم اعتبار إفراغ swap قسرًا إجراءً آمنًا أثناء الامتلاء؛ فقد يتطلب RAM غير متاحة ويزيد الأزمة.
لا تنس أن خدمات قاعدة البيانات تستخدم الذاكرة أيضًا وأن ضغط المهام قد يرفع عدد اتصالاتها. عندما يتباطأ الخادم، تتراكم طلبات المستخدم، ويولد كل طلب منتظر موارد إضافية. هذه حلقة تغذية راجعة تزيد المشكلة بدل أن تمنح العمليات القديمة وقتًا للانتهاء. استجابة عملية: أوقف استقبال وظائف خلفية جديدة قبل أي تجربة تغيير كبيرة، وضع أولوية ثابتة لاستمرار صفحات الموقع وواجهات المستخدم.
ما معنى OOM Killer وكيف تقرأ دليله؟
عندما لا يستطيع النظام تخصيص ذاكرة كافية قد يختار kernel عملية لإنهائها. راجع سجل النواة من journalctl -k وابحث عن out of memory أو Killed process واسم العملية والوقت. لكن انتبه إلى احتمال وجود حد على مستوى cgroup، حيث يمكن قتل عملية داخل مجموعة موارد رغم وجود ذاكرة متاحة على مستوى المضيف. لذلك اربط رسائل OOM بحد MemoryMax وذاكرة المجموعة وعدد مرات إعادة التشغيل. مجرد اختفاء PID لا يثبت أن النظام قتله بسبب الذاكرة.
فرّق بين exit code ناتج عن خطأ JavaScript، وبين SIGKILL خارجي، وبين إنهاء مقصود بعد timeout. المتابعات الآلية التي تعيد تشغيل الخدمة فور كل موت يمكن أن تؤدي إلى Crash Loop يستهلك المزيد من الموارد. استخدم StartLimit و RestartSec واستراتيجية backoff مناسبة، مع تحذير عند تكرار الإقلاع الفاشل. الإصلاح الحقيقي يحدد لماذا ماتت العملية؛ وإلا فإن نظام إعادة التشغيل يحافظ على دورة العطل.
كيف تفحص Heap في Node.js بصورة مسؤولة؟
راقب process.me moryUsage() على فترات مناسبة، مع اهتمام خاص بقيم heapUsed و heapTotal و external و rss. لا تسجل الاستهلاك في كل طلب فتضاعف الحمل؛ يكفي أخذ عينات زمنية وربطها بعدد المهام النشطة. عند الشك في تسرب، نفذ اختبار حمل مضبوط يليه وقت خمول وقارن الخط الأساس، ثم استخدم heap snapshot في بيئة يمكنها تحمل تكلفة الالتقاط، لأن أخذ لقطة كاملة قد يوقف التنفيذ مؤقتًا ويرفع الحاجة للذاكرة.
ابحث عن cache بلا حد، ومستمعي أحداث لم تُزل، ومراجع تظل في مصفوفات أو خرائط، ومؤقتات لم تُلغ، ووعود تنتظر إلى الأبد. لا ترفع --max-old-space-size بشكل تلقائي؛ فهذا يغير حد Heap فقط ولا يمنع ضغط بقية العمليات. واحذر أن استخدام RSS المرتفع لا ينتج دائمًا من Heap JavaScript، فقد تكون الذاكرة مرتبطة بمكتبة أصلية أو buffers أو تجزئة memory allocator. اعزل المصدر قبل التعديل.
فصل موارد الموقع عن العمال
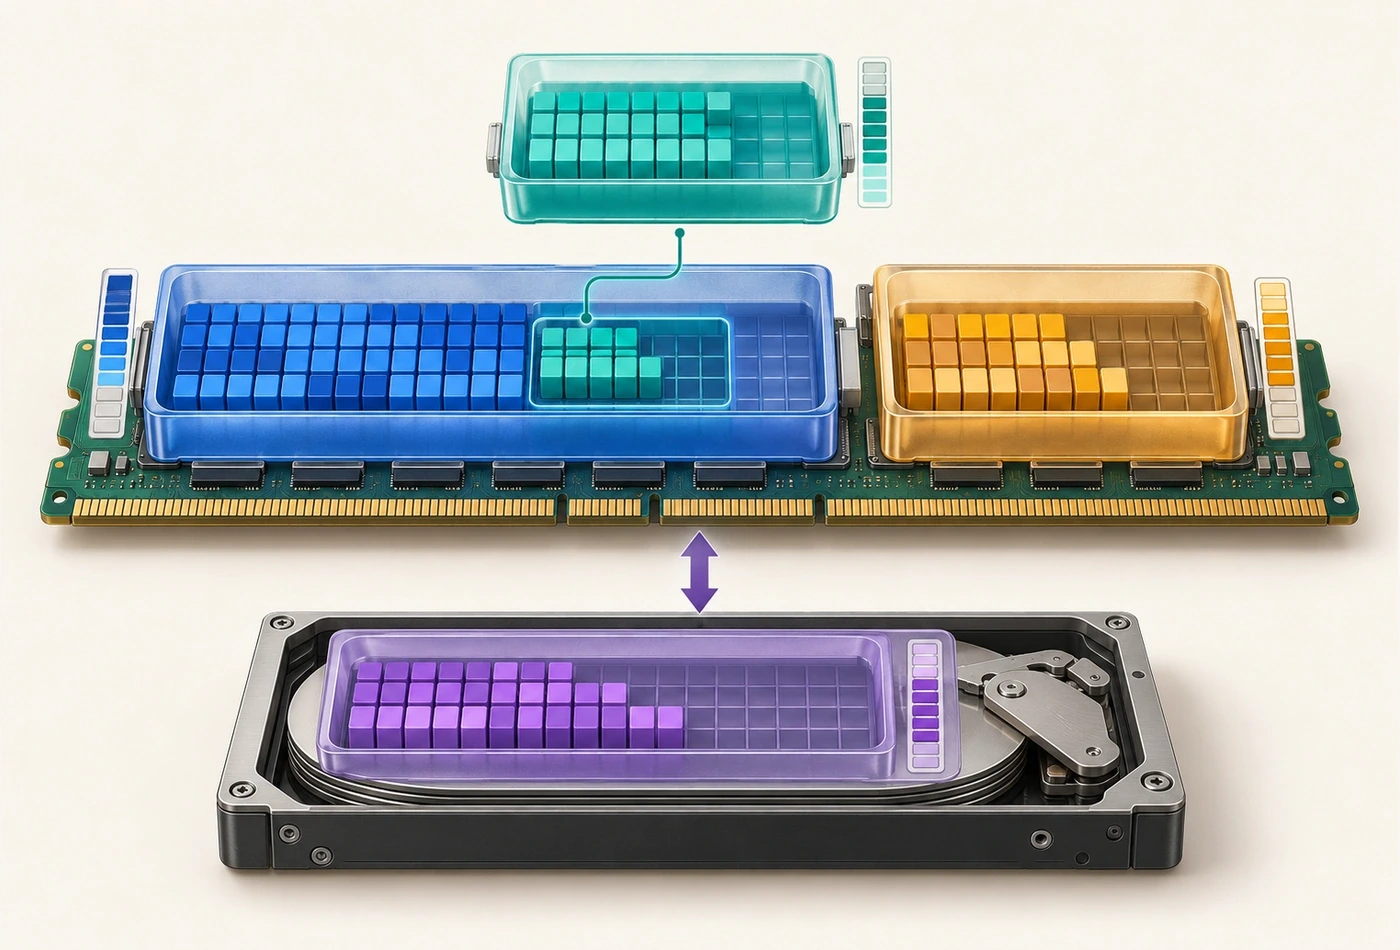
التصميم العملي يفصل الويب الذي يخدم المستخدم عن طابور أعمال بطيئة مثل التوليد والتحرير والصور. ضع لكل طابور تزامنًا منخفضًا وحدًا للمهلة وللاستهلاك. يمكن لوحدات systemd استخدام MemoryMax و CPUQuota و RuntimeMaxSec، لكن يجب التحقق من وراثة الحدود للعمليات التابعة والوحدات العابرة. لو كان العامل يشغّل برنامجًا آخر بطريقة تنشئ خدمة منفصلة، فقد يظل الابن حيًا بعد انتهاء الأب؛ لذلك اختبر إنهاء شجرة العمل في سيناريو فشل حقيقي.
الحدود أدوات حماية وليست علاجًا لجودة الكود. إذا كانت ذاكرة الموقع 12 جيجابايت مثلًا، لا تخصص 11 جيجابايت للعمال وتترك الباقي لخادم الويب وقاعدة البيانات والنظام. احسب ميزانية لكل فئة بعد مراقبة قمم حقيقية، ثم احتفظ باحتياطي قابل للاستخدام. قد تكون مهمة صورة واحدة أثقل من عدة مقالات نصية؛ لذا لا تضاعف التزامن بناءً على عدد المهام وحده.
قرار الحادث: ماذا توقف وماذا تحفظ؟
ابدأ بتوثيق PID واسم العملية ووقت الإطلاق والأمر المختصر دون أسرار، ثم افصل المؤقت الذي يخلق أعمالًا جديدة. إذا كانت العمليات غير الحرجة كثيرة ومكررة، أنهها تدريجيًا بعد حفظ تقدم الطابور وملفات النتائج، ولا تحذف محتويات الوظائف. راقب تغير الذاكرة خلال دقائق؛ إذا تحسنت الخدمة دون تعديل كود الموقع فهذا دليل قوي أن التزامن كان أحد الأسباب. بعد تحرير الموارد أعد اختبار قاعدة البيانات والخادم والصفحات، وقد تتطلب عملية علقت أثناء التهيئة إعادة تشغيل محددة.
اجعل إيقاف الأعمال قابلاً للعكس: تعطيل timer مؤقتًا يختلف عن حذف وحدة الخدمة. ضع سجلًا يذكر المهام التي لم تكتمل، وأعدها إلى pending أو retry عند الحاجة، واحترم idempotency لمنع تنفيذ نفس عملية النشر مرتين. لا تفترض أن المهمة التي لم تكتب نتيجة قد فشلت بالكامل؛ ربما نفذت أثرًا خارجيًا ثم انقطع الحفظ. لهذا تتطلب الأعمال التي تغير بيانات قاعدة البيانات معرف عملية فريدًا وسجلًا قابلًا للمطابقة.
جدول التشخيص وتفسير القياس
إذا ارتفع عدد العمليات بينما بقي RSS لكل عامل متقاربًا، ابدأ بنظام الجدولة. إذا ارتفع RSS لنفس PID عبر ساعات مع خمول ثابت، افحص التسرب أو cache بلا حد. إذا زاد swap والقرص بطيء وأخطاء مهلة قاعدة البيانات منتشرة، عالج ضغط الذاكرة لا زمن انتظار Nginx فقط. وإذا رأيت Killed process في journal مع حد cgroup، تحقق من MemoryMax والموارد الفعلية للمجموعة، لا إجمالي ذاكرة الجهاز.
لا تستخدم حدًا واحدًا عامًا للتنبيه. اربط مؤشر الخطر بثلاثة أبعاد: صحة الخدمة، الموارد، والعمل المنتظر. هبوط available دون زيادة أخطاء قد يعني ذروة قابلة للتحمل، أما زيادة المهلات مع نمو العمال وال ـswap فتستحق تدخلًا سريعًا. قوائم الفحص المختصرة أفضل من لوحات مليئة بمقاييس لا يقود أي منها إلى إجراء معروف.
خطة تحسين قابلة للقياس
حدد هدفين مختلفين: أقصى وقت استعادة الخدمة من حادث موارد، وأقصى عدد وظائف مسموح متزامنة من كل فئة. نفذ اختبارًا في بيئة غير إنتاجية بتشغيل مهام أطول من المهلة وأخرى تفشل باتصال خارجي، وتأكد أن عدد العمليات لا ينمو بلا حد. راقب استرجاع موارد العمال وتحرير اتصالات قاعدة البيانات وإعادة المهمة المؤجلة من دون تكرار محتواها.
المصادر المفيدة: توثيق Node.js حول process.me moryUsage على nodejs.org، وتوثيق systemd.resource-control على freedesktop.org، وإرشادات Google SRE عن cascading failures. لا تنس أن معدلات استهلاك محددة على جهازك أفضل من نسخ قيم جاهزة من دروس عامة. الأمان التشغيلي هنا يعني جعل فشل مهمة محتوى أو صورة لا يحرم المستخدم من تحميل صفحة واحدة.
مؤشرات تشخيصية وليست أحكامًا قاطعة؛ اربطها بالسجلات وزمن الحادث
| عمليات كثيرة و RSS ثابت | تداخل مهام | افحص المؤقتات والقفل |
| PID واحد يزيد باستمرار | تسرب أو Cache متنام | راقب Heap بعد الخمول |
| Swap مرتفع وتأخر I/O | ضغط ذاكرة | راقب available و kswapd |
| قتل عملية داخل cgroup | تجاوز حد المجموعة | راجع MemoryMax وسجل kernel |
شارك في تقييم ونقاش المقال
رأيك يضيف قيمة للمقال ويساعدنا على تحسين المحتوى والنقاش حوله.
النقاش
جارٍ تحميل التعليقات…