خطأ 502 ليس تشخيصًا كاملًا، وإنما علامة على فشل الحوار بين Nginx والخدمة الخلفية. إليك طريقة عملية لفحص المشكلة من دون التضحية بعمل الخدمات الأخرى أو إخفاء أدلتها، مع تفسير للحالات الشائعة وخطة وقاية تصلح للخوادم الصغيرة والمتوسطة.
فهم رمز الخطأ قبل العلاج
Nginx يعمل كوسيط بين المتصفح والخدمة الخلفية، وعندما يفشل في الحصول على رد صالح من المنبع قد يعيد 502. لا يعني هذا أن DNS أو HTTPS معطلان بالضرورة، بل قد يكون المنفذ مغلقًا أو التطبيق لم يكتمل تشغيله أو أغلق الاتصال مبكرًا. يبدأ التحقيق بالسؤال: هل يستقبل Nginx الطلب أصلًا؟ وهل المنبع متاح؟ وهل الفشل دائم أم يتكرر تحت الضغط؟ هذه الأسئلة تفصل المشكلات في دقائق دون افتراض سبب واحد.
قارن 502 مع 504 و 503 بدل التعامل معها كمرادفات. 504 تشير عادةً إلى انتهاء انتظار الرد من المنبع؛ و 503 قد تعني عدم توافر خدمة نتيجة سياسة أو ضغط؛ أما 502 فقد تنتج من استجابة غير صالحة أو فشل اتصال. ومع ذلك لا تُشخّص حادثًا اعتمادًا على الرمز وحده، لأن إعدادات الوكيل قد تغيّر ما يراه العميل. الأهم سجل Nginx مع سجل التطبيق ومعرف الطلب في اللحظة نفسها.
ابدأ باختبار ثلاثة مسارات
افتح الصفحة الرئيسية ومسارًا يعتمد على قاعدة البيانات ومسار صحة داخليًا، ثم سجّل رمز كل استجابة وزمنها. إذا نجح مورد ثابت وفشل مسار المقالات الديناميكي، فغالبًا الخلل بعد طبقة الاستقبال. وإذا فشلت كل الخدمات من خارج الشبكة لكن المنفذ الخلفي يجيب محليًا، راجع إعدادات التوجيه والبروكسي. اختبر أيضًا IPv4 و IPv6 عند وجود عنوانين للنطاق، ولا تفترض أن نجاح بروتوكول منهما يضمن الآخر.
سجل التاريخ الدقيق لكل نتيجة، لا كلمة يعمل أو لا يعمل فحسب. مثال فحص غير حساس للبيانات: curl -sS -o /dev/null -w '%{http_code} %{time_total}\n' https://example.com/ar/ . راجع وقت تشغيل آخر إصدار وتوقيت المهام الدورية. لا تسجل توكنات الدخول داخل أوامر مكشوفة أو نسخ مشتركة من ملفات السجلات. الهدف من الفحص الأول ليس إصلاح المشكلة بل حصر مجال البحث قبل لمس خدمة الإنتاج.
كيف تقرأ سجل Nginx؟
ابحث في error.log عن رسالة رفض اتصال أو إغلاق مبكر أو غياب منفذ حي. عبارة connection refused تعني أن وجهة الاتصال رفضت الطلب، وقد تدل على منفذ غير مستمع أو عنوان خاطئ. ورسالة upstream prematurely closed connection تشير إلى إغلاق المنبع قبل اكتمال الرد. أما no live upstreams فتتعلق بمجموعة الوجهات المتاحة وفق التكوين. كل رسالة دليل أولي لا برهان وحيد؛ اربطها بما سجله التطبيق في اللحظة نفسها.
يساعد تضمين upstream_status و upstream_response_time و request_time في سجلات الوصول على فصل وقت الانتظار الخارجي عن وقت المعالجة الداخلية. لا تعدل السجلات بطريقة تسرب Cookie أو Authorization، واجعل لها سياسة احتفاظ محدودة. عند مقارنة زمن طلب ناجح بزمن طلب فاشل، حاول استخدام المسار نفسه ومقارنة الحمل في وقتين مختلفين؛ وإلا فقد تقارن طلبًا سريعًا ثابتًا بطلب معقد يعتمد على ثلاثة أنظمة.
تحقق من الاستماع على المنفذ الصحيح
راجع proxy_pass وتكوينه الفعلي بعد ضم ملفات include، ثم نفذ ss -ltnp لترى ما إذا كانت العملية تستمع على العنوان والمنفذ المتوقعين. يمكن لمدير العمليات أن يعرض عملية online في حين لم تستدعِ الخدمة listen() بعد بسبب تهيئة قاعدة البيانات أو تحميل الإعدادات. استخدم curl على 127.0.0.1 والوجهة الدقيقة، وقارنها بما يشير إليه upstream. لا تكتف باسم التطبيق أو رقم العملية في القائمة.
في بيئات الحاويات والشبكات المتعددة، لا يعني نجاح الاتصال من المضيف نجاحه من حاوية Nginx، والعكس صحيح. راجع أسماء الخدمات وواجهات الربط وترجمة المنافذ دون فتح منافذ داخلية للعامة. إذا كان المنبع يعمل على IPv6 فقط أو يستخدم socket ملفيًا، تحقق من صيغة الوجهة والصلاحيات. وعندما تعثر على اختلاف إعدادات، اختبر التكوين عبر nginx -t قبل إعادة تحميل Nginx تدريجيًا.
علاقة قاعدة البيانات بخطأ 502
يمكن أن يفشل التطبيق قبل فتح منفذه بسبب مهلة اتصال PostgreSQL، أو يغلق اتصالات أثناء طلب حقيقي. اختبر أن قاعدة البيانات تقبل اتصالات مستقلة ثم افحص pool التطبيق وعدد الاتصالات النشطة والاستعلامات المنتظرة. نجاح pg_isready يعني أن الخادم يستقبل اتصالات، لكنه لا يضمن نجاح كل استعلام أو سلامة صلاحيات حساب التطبيق. استخدم عملية قراءة محدودة بدل تنفيذ إصلاحات خطرة أو إعادة تشغيل عشوائية للقاعدة.
إذا لاحظت انتهاء مهلات الاتصالات متزامنًا مع تضخم عدد العمال أو ارتفاع استخدام swap، فاعتبر استنزاف الموارد فرضية قوية، وليس دليلًا قاطعًا على خطأ في قاعدة البيانات نفسها. انظر إلى حجم تجمع الاتصالات بالنسبة إلى عدد نسخ التطبيق، لأن ضرب pool كبير في عشرات العمليات يولد ضغطًا يفوق عدد المستخدمين الحقيقيين. معالجة السبب هنا قد تكون تقليل التزامن وإيقاف مهمة خلفية منفلتة لا رفع max_connections بلا دراسة.
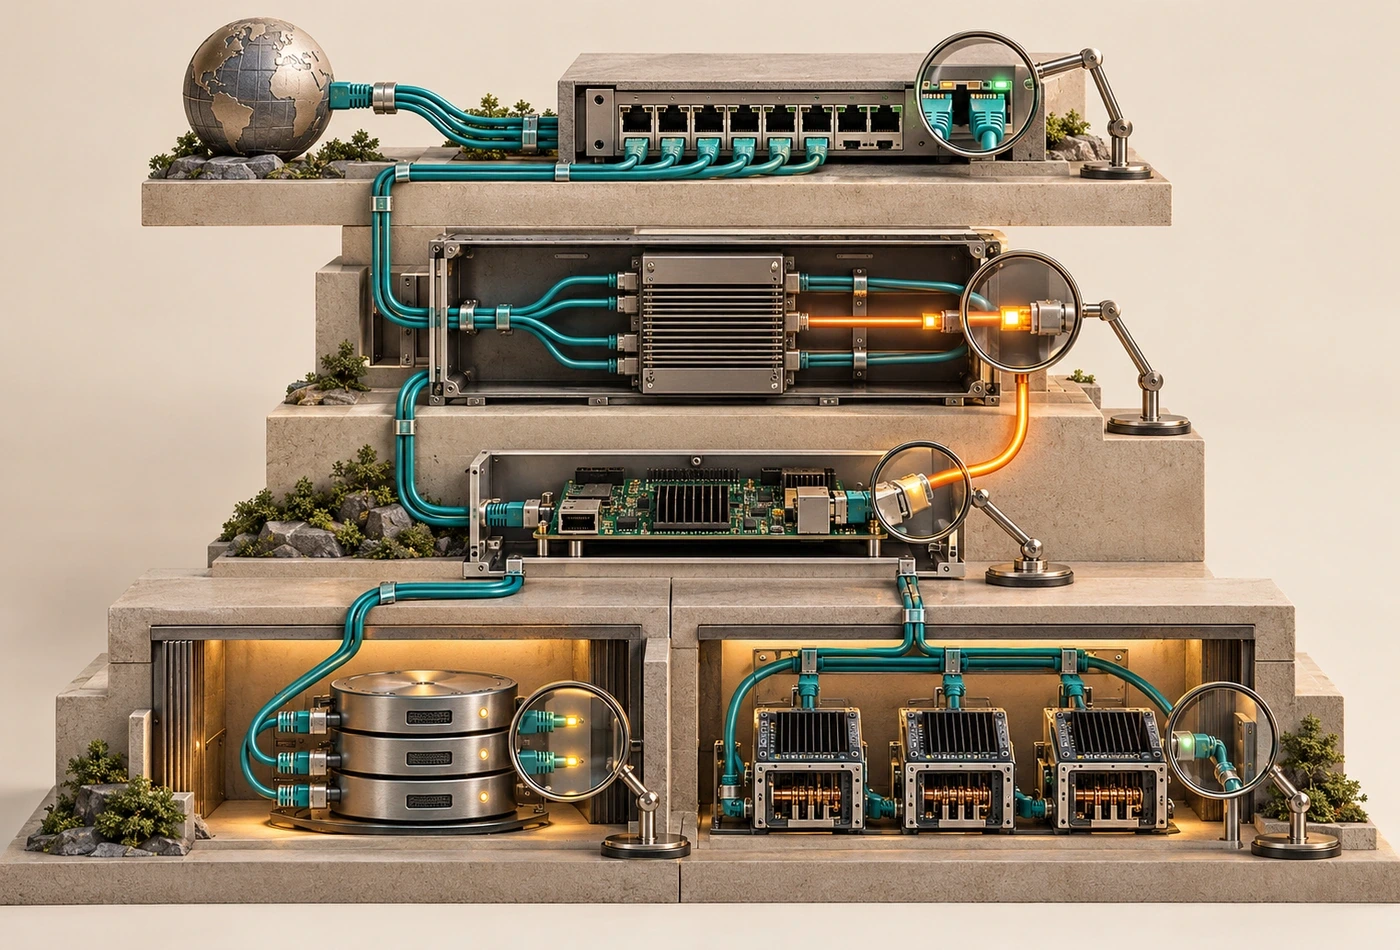
كيف يتحول ضغط الخلفية إلى توقف علني؟
عندما تنطلق عشرات المهام الثقيلة بالتوازي قد يرتفع استهلاك الذاكرة إلى حد يبدأ النظام عنده نقل الصفحات إلى swap؛ فتبطؤ الاستعلامات وتتأخر مرحلة إقلاع التطبيق. وإذا نفدت الموارد أكثر، قد تظهر استثناءات أو يقتل النظام عمليات بسبب OOM. لا تعالج ذلك بإعادة تشغيل كل الخدمات أو بإطالة مهلة الوكيل فقط، لأن المزيد من الطلبات المنتظرة قد يزيد الأزمة ويصنع فشلًا متسلسلًا.
ابدأ بإيقاف إنشاء مهام جديدة من مصدرها، واحفظ حالة طابورها، ثم قلل التشغيل المتوازي بصورة يمكن الرجوع عنها. راقب free و uptime ورسائل الذاكرة في journalctl وسجل قاعدة البيانات. لا تحذف ملفات الجلسات أو سجل الأعمال بحجة تحرير المساحة، ولا تقتل كل عمليات Node.js لمجرد تشابه الاسم. أوقف الفئة غير الحرجة فقط واترك خادم الموقع وواجهات البيانات الضرورية تعمل.
جدول مقارنة عملي بين الأعراض
التشخيص وفق العرض: إذا كان المنفذ الخلفي مغلقًا، افحص سجل الإقلاع وتطابق المنفذ؛ وإذا كان مفتوحًا لكن readiness يفشل، افحص اعتماديات التطبيق؛ وإذا نجح الطلب محليًا وفشل عامًا، افحص إعداد Nginx والشبكة؛ وإذا كانت الأخطاء تظهر أثناء الجدولة فقط، فافحص موارد النظام وعدد العمال؛ وإذا فشل مسار واحد، فابدأ من معالج ذلك المسار واستعلاماته قبل اتخاذ قرار يخص الخادم كله.
لا توجد قاعدة واحدة تصلح لجميع البنى. الاختبار الصحيح يكون بفرضية قابلة للتكذيب: هل تعود الخدمة عند تحرير الذاكرة مع بقاء الكود نفسه؟ هل يؤدي استدعاء health من العنوان الخلفي إلى رد موثوق؟ هل يطابق سجل Nginx توقيت انهيار التطبيق؟ كل إجابة تضيق مجال البحث. استخدام قرار مبني على دليل أفضل من تبديل خمسة إعدادات دفعة واحدة لأنك لن تعرف أي تغيير صنع الفرق.
إعادة التشغيل والتحقق من التعافي
إذا اتضح أن التطبيق عالق بعد زوال الضغط، أعد تشغيل الخدمة المحددة فقط مع تتبع زمن فتح المنفذ. لا تفترض أن عملية ظهرت في PM2 أصبحت مستعدة لتلقي الزيارات، وأعد فحص endpoint محليًا ثم عبر النطاق. إذا احتجت تعديل Nginx فتحقق من صحة الملف ثم reload بدل إيقاف الخادم كليًا. احتفظ بخطة رجوع وأرقام نسخ الملفات لتقليل أثر الإصلاح على بقية الخدمات.
اختبر بعد العلاج الصفحة الرئيسية وأحدث المقالات وصفحة تفاصيل وواجهة API والمسارات الإدارية المسموح بفحصها دون تغيير بيانات. كرر القياس على فترة تتضمن تشغيلًا جديدًا للمهام الخلفية، وراقب عودة 502 وعدد الاتصالات والذاكرة. إذا ظل الحمل منخفضًا واستعادت كل المسارات استجابتها فهذه دلائل تعافٍ قوية، لكنها لا تلغي الحاجة إلى مراقبة دورية لكشف عودة المشكلة في أوقات الذروة.
خطة وقاية قابلة للتطبيق
ضع حدًا زمنيًا لكل عامل وحدًا للذاكرة وعدد المهام المتوازية، وأضف قفلًا يمنع تراكب نفس المهمة. ميّز بين فحص liveness الذي يقرر إن كانت العملية حية وفحص readiness الذي يقرر إن كانت قادرة على الخدمة. أنشئ تنبيهًا عند ارتفاع فشل HTTP وذاكرة الخادم وزمن انتظار قاعدة البيانات. واجعل عمليات إنشاء المقالات أو الصور أقل أولوية من التطبيق الذي يستخدمه الزائر.
وثق الحادث في خط زمني: متى بدأ، أي مراقبة التقطته، ما السبب المرجح المدعوم بالأدلة، ماذا تغير، وكيف تحقق الفريق من النجاح. راجع مصادر Nginx الرسمية لوحدتي proxy و upstream، ووثائق PostgreSQL حول max_connections، وفصل Cascading Failures من Google SRE. المصادر تشرح المبادئ العامة؛ أما قيم المهلة والتزامن المناسبة فتحتاج قياسًا على خادمك. المهم ليس منع كل الأعطال تمامًا بل جعل اكتشافها واحتواء أثرها قابلين للتكرار.
الترتيب المقترح أثناء الحادث
- قياس المسارات الخارجية والمحلية
- مراجعة رسائل Nginx مع سجل المنبع
- فحص المنفذ وجاهزية التطبيق
- قياس الذاكرة و PostgreSQL والمهام
- إصلاح السبب المرجح ثم إعادة الاختبار
شارك في تقييم ونقاش المقال
رأيك يضيف قيمة للمقال ويساعدنا على تحسين المحتوى والنقاش حوله.
النقاش
جارٍ تحميل التعليقات…