

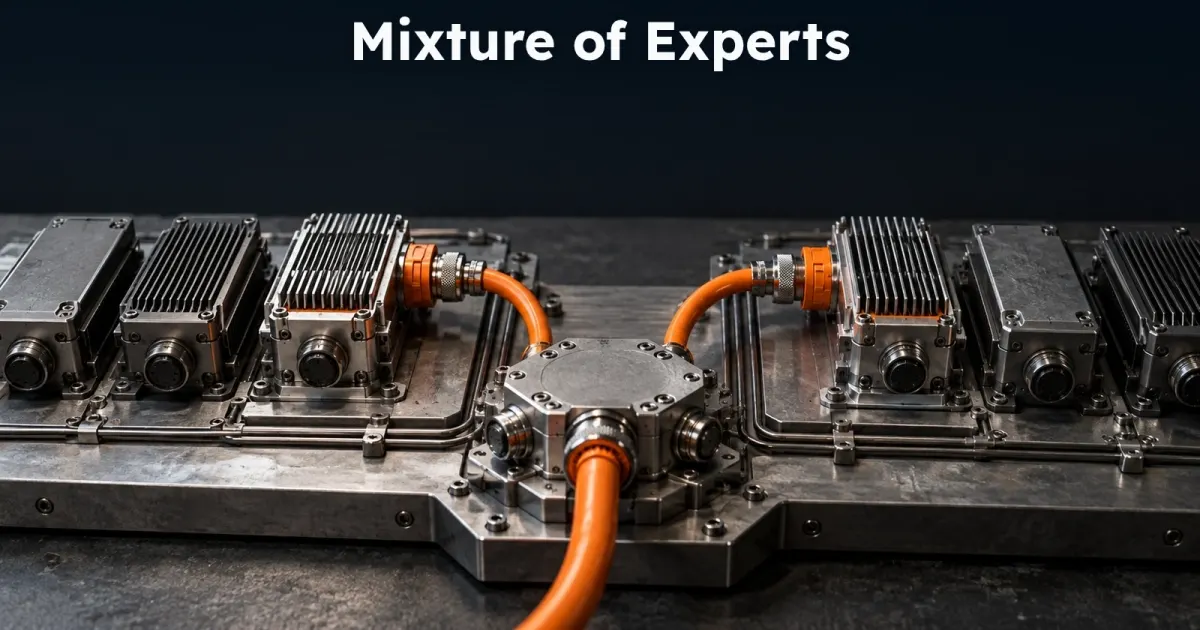
السعة ليست نفس تكلفة التنفيذ
يمكن أن يحتوي النموذج على عدد كبير من المعاملات إجمالًا، بينما يستخدم جزءًا منها فقط لكل خطوة، لذلك يجب التفريق بين total parameters و active parameters.
لماذا البنية أصعب تشغيليًا؟
إذا اختار router نفس الخبراء بكثرة تظهر مشكلة imbalance، كما أن توزيع experts على accelerators يجعل حركة البيانات والتواصل جزءًا مهمًا من الأداء.
ما معنى اختيار الخبراء في MoE؟
تحتوي نماذج Mixture of Experts على مجموعات شبكات فرعية يشار إليها بالخبراء، ويقرر Router أي الخبراء يعالج تمثيل رمز أو Token معين حسب التصميم. قد تُفعّل مجموعة صغيرة فقط من الخبراء لكل Token، وهو ما يسمى Sparse Activation. لذلك يمكن أن يكون العدد الإجمالي لمعاملات النموذج كبيرًا مع تكلفة حساب أقل لكل خطوة مقارنة بتفعيل الجميع، لكن الذاكرة المطلوبة لتخزين الخبراء قد تظل كبيرة.
لماذا لا تعني معاملات كثيرة أداء أعلى تلقائيًا؟
يعتمد الأداء على جودة التدريب وآلية التوجيه وتوزيع البيانات وطريقة جمع مخرجات الخبراء. قد يزيد حجم نموذج MoE دون أن تتحسن مهمة المستخدم إذا كان اختيار الخبراء غير مناسب أو البيانات غير متوازنة. كما أن المقارنة المباشرة بين Total Parameters في نموذجين قد تكون مضللة عندما يختلف عدد المعاملات النشطة لكل Token. قارن النتائج على مهام محددة وبظروف استدلال متشابهة.
موازنة الحمل أثناء التدريب
إذا وجه Router جزءًا كبيرًا من الرموز إلى خبير واحد فقد يصبح نقطة ازدحام، بينما لا يحصل خبراء آخرون على أمثلة كافية للتعلم. تستخدم بعض التصاميم آليات لتشجيع التوزيع أو تحديد سعة الخبراء أو التعامل مع الرموز الزائدة. هذه القرارات تؤثر على استقرار التدريب والاستفادة من المعالجات. لذلك لا يعد Routing مجرد عملية تصنيف بسيطة، بل جزءًا من تصميم النظام الحاسوبي للنموذج.
التحدي في النشر على عدة GPUs
قد توزع الخبراء عبر أجهزة تسريع مختلفة، فيصبح تبادل التمثيلات بين الأجهزة وتنسيق النتائج عبئًا كبيرًا. يختلف الأداء حسب عرض النطاق وزمن النقل وعدد الدفعات وطول السياق. قد يكون نموذج MoE سريعًا عند حجم Batch معين وبطيئًا عندما يختلف نمط الحمل. اختبر استخدام الذاكرة والحركة بين الأجهزة وزمن أول Token وزمن إنتاج بقية الرموز قبل اعتماد النشر.
مثال لفهم الفرق بين Total و Active
افترض نموذجًا تجريبيًا يحتوي على خبراء متعددين، ويختار Router خبيرين من عدة خبراء في إحدى الطبقات لكل رمز. لن تُستخدم كل أوزان هؤلاء الخبراء في تلك الخطوة، لكن يجب أن تكون الأوزان المطلوبة متاحة في البنية التشغيلية. هذا مثال مفاهيمي وليس وصفًا لموديل تجاري بعينه. ولذلك لا تحول نسبة عدد الخبراء المختارين إلى نسبة مساوية مباشرة من زمن الاستدلال أو استهلاك الذاكرة.
كيف تقارن MoE بنموذج كثيف؟
حدد أولا مهامك: الاستدلال النصي أو البرمجة أو التلخيص أو العربية، ثم قارن جودة الإجابات والتكلفة وزمن الاستجابة وثبات النتائج على العتاد المتاح. استخدم نفس حدود السياق ونوعية الاختبارات وتحقق من أن دقة الأوزان وتقنيات التسريع موثقة. اختيار MoE ليس هدفًا مستقلًا؛ فقد يكون نموذج كثيف أصغر أنسب للنشر المحلي إذا كانت قيود الذاكرة هي العامل الحاسم.











شارك في تقييم ونقاش المقال
رأيك يضيف قيمة للمقال ويساعدنا على تحسين المحتوى والنقاش حوله.
النقاش
جارٍ تحميل التعليقات…