

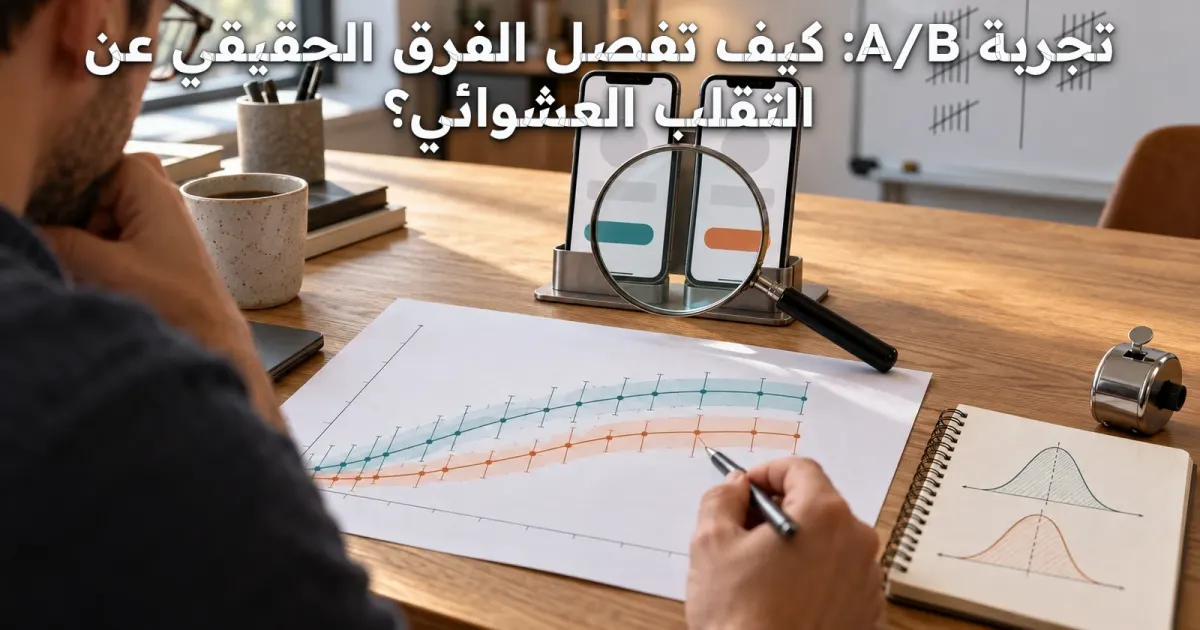
يبدأ كثير من فرق المنتج والتسويق تجربة A/B بحماس، ثم يفسّرون النتائج بسرعة أكبر من سرعة جمعها. يظهر فرق صغير في معدل التحويل بعد يومين، فيُعلن الفائز ويُنشر التغيير، ثم تتراجع النتيجة لاحقًا أو تنقلب. المشكلة غالبًا ليست في الأداة، بل في قراءة التقلب العشوائي كأنه إشارة حقيقية. هذا المقال يركّز على سؤال عملي محدد: كيف نفصل الفرق الحقيقي عن ضجيج العينة؟ سنشرح الفرضية الصفرية، وتقلب العينة، وحجم العينة والقدرة الإحصائية، والقيمة الاحتمالية وفواصل الثقة، ومشكلات النظر المتكرر والاختبار المتعدد، وحجم الأثر مقابل المعنوية، وتأثيرات الحداثة والموسمية، والتحقق من صحة التقسيم، وتحليل الفئات الفرعية دون الوقوع في مفارقة سيمبسون. الهدف ليس حفظ مصطلحات، بل بناء قرار موثوق قابل للتكرار، حتى لا نبني استراتيجية على صدفة قصيرة العمر. والقارئ سيجد خطوات يمكن تطبيقها قبل الإطلاق وأثناءه وبعده، مع قائمة تحقق تقلل احتمال أن تخدعك لوحة نتائج لامعة.
من السؤال العملي إلى الفرضية القابلة للقياس
قبل إطلاق أي تجربة، حوّل السؤال الغامض إلى قرار واحد قابل للقياس. يسأل فريق التسويق افتراضيًا: هل يرفع تغيير نص الزر معدل إتمام الطلب؟ هنا المؤشر الأساسي هو نسبة الطلبات المكتملة لكل زيارة، وليس عدد النقرات وحده. غيّر عنصرًا واحدًا قدر الإمكان، لأن تعديل العنوان واللون والسعر معًا يجعل نسب الفرق إلى سبب واحد مستحيلًا. اكتب المؤشر الأساسي، والمؤشرات الثانوية، ووحدة التوزيع، ومدة الجمع، وشرط التوقف مسبقًا قبل رؤية أي رقم.
الفرضية الصفرية تفترض عدم وجود فرق حقيقي بين النسختين، والفرضية البديلة تفترض وجود فرق. وحدّد وحدة العشوائية بدقة: المستخدم، لا الجلسة، لأن المستخدم نفسه قد يعود عدة مرات فيلوّث مجموعته إذا وزّعناه على الجلسات. عرّف أيضًا جمهور التجربة وشروط الاستبعاد، مثل الزيارات الآلية أو الحسابات الداخلية. هذه التفاصيل ليست إجراءات شكلية، بل هي ما يجعل النتيجة قابلة للتفسير لاحقًا وقابلة للتكرار عند إعادة التشغيل، ويحميك من اكتشاف أنك قست شيئًا غير الذي قصدته.
تقلب العينة: لماذا تتغير النتيجة دون أي تغيير حقيقي؟
حتى لو لم تغيّر شيئًا، فإن رقمك سيتغير من ساعة إلى أخرى. هذا هو تقلب العينة: كل مجموعة زوار عشوائية تحمل مزيجًا مختلفًا قليلًا من السلوك، فيبدو الفرق بين النسختين حقيقيًا أحيانًا وهو مجرد صدفة. أسوأ ما يمكن فعله هو مراقبة اللوحة كل ساعة واتخاذ قرار عند أول قفزة مغرية. هذا السلوك يمنح العشوائية فرصًا لا نهائية لتقديم نتيجة مبهرة عابرة، ثم نُعلن فائزًا لا وجود له في الواقع.
تخيّل رمي عملة متوازنة عشر مرات فقط. من الطبيعي جدًا أن تحصل على سبع صور مقابل ثلاث كتابات، وقد توحي النتيجة بأن العملة غير متوازنة، لكن عشر رميات لا تكفي للحكم. التجارب الصغيرة تعاني من الأمر نفسه: مع قلة التحويلات يكون هامش الخطأ واسعًا، وأي فرق ظاهر قد يكون ضجيجًا خالصًا. القاعدة العملية أن تسأل قبل كل شيء: هل لديّ حجم بيانات يسمح لأصغر فرق مهم بأن يظهر أصلًا، أم أنني أطارد أرقامًا صغيرة مضطربة؟
حجم العينة والقدرة الإحصائية قبل الإطلاق
حدّد حجم العينة قبل الإطلاق بناءً على أصغر فرق يستحق الكشف عمليًا، لا بعد رؤية النتائج. إن كنت تتوقع رفع معدل التحويل من 3% إلى 3.3%، فهذا فرق صغير يحتاج عينة أكبر بكثير من رفع 3% إلى 6%. استخدم حاسبة حجم العينة التي تطلب أربعة مدخلات: المعدل الأساسي، والحد الأدنى للفرق القابل للكشف، ومستوى الثقة، والقدرة الإحصائية المطلوبة. القيم الشائعة اصطلاحًا هي ثقة 95% وقدرة 80%، لكن العبرة بملاءمتها لقرارك ودرجة تحمّلك للخطأ.
القدرة الإحصائية هي احتمال أن تكشف فرقًا حقيقيًا موجودًا فعلًا. تجربة ضعيفة القدرة معناها أنها تفوّت فروقًا حقيقية وتتركها تبدو كأنها لا شيء. الأسهل غالبًا ليس زيادة المدة حتى تتضخم البيانات، بل اختيار مؤشر أكثر حساسية أو تضييق نطاق السؤال. والمدة ليست هدفًا بحد ذاتها؛ فتغطية دورة شراء كاملة قد تكون ضرورية لا لأن الأرقام ستنضج، بل لأن سلوك أيام الأسبوع يختلف، وهذا يمنع قراءة موسمية خاطئة عند نهاية التجربة.
القيمة الاحتمالية وفواصل الثقة: كيف تُقرأ دون مبالغة؟
القيمة الاحتمالية تجيب عن سؤال ضيق: لو كانت الفرضية الصفرية صحيحة، ما احتمال أن نرى فرقًا بهذا الحجم أو أكبر؟ هي ليست احتمال أن تكون النسخة الجديدة أفضل، وليست احتمال أن تكون النتيجة صدفة بالمعنى العامي. عتبة 0.05 اصطلاح شائع، وتعني قبول خطأ إيجابي كاذب في حدود 5% على المدى الطويل. لا تحوّل هذه العتبة إلى قاضٍ نهائي؛ فقيمة 0.049 ليست نجاحًا مؤكدًا، و 0.051 ليست فشلًا محتومًا، والسياق التقريري حولهما هو ما يحسم.
فاصل الثقة أوضح للقارئ غير المتخصص لأنه يعطيك مدى القيم المعقولة لحجم الفرق، لا حكمًا ثنائيًا فقط. إذا كان الفاصل يمتد من ربح طفيف إلى خسارة كبيرة، فأنت لا تملك قرارًا بل غموضًا يحتاج بيانات أكثر. الأمر الأهم أن تفحص الحجم لا الاتجاه فقط: فاصل ثقة ضيق حول فرق بسيط قد يكون أكثر إفادة من فاصل عريض حول رقم مبهر. اعرض الفواصل دائمًا بجانب معدلات التحويل الخام لتقرأ الصورة كاملة لا مجرد إشارة واحدة.
النظر المتكرر والاختبار المتعدد: أخطر باب خلفي للنتائج الكاذبة
النظر المتكرر يعني فحص النتائج خلال التجربة ثم التوقف عند أول لحظة تبدو فيها معنوية. هذه أبسط طريقة لتخريب تجربة سليمة، لأن كل نظرة إضافية تزيد احتمال رؤية صدفة تتجاوز العتبة. إذا نظرت عشرين مرة بعتبة 5%، فإن احتمال خطأ إيجابي كاذب مرة واحدة على الأقل يرتفع كثيرًا ويتجاوز بكثير الخمسة بالمئة المعلنة. الحل الأنظف أن تحدّد حجم العينة أو المدة سلفًا، ولا تقرأ النتيجة الحاسمة قبل نهايتها.
الاختبار المتعدد يقع عندما تقارن عدة نسخ أو عدة مؤشرات ثم تختار أبرز نتيجة إيجابية. كل مقارنة إضافية تفتح بابًا جديدًا للصدفة. عدّل العتبة عند اختبار فرضيات متعددة، مثل تقسيم المستوى المستهدف على عدد المقارنات، أو استخدم طرقًا تخفض معدل الاكتشاف الكاذب. والأفضل عمليًا أن تحدّد مؤشرًا أساسيًا واحدًا مسبقًا، وتتعامل مع الباقي بوصفه استكشافيًا يحتاج تجربة تأكيدية مستقلة قبل أن يُبنى عليه أي قرار نشر.
حجم الأثر مقابل المعنوية: الفرق الذي يهم العمل
الفرق المعنوي إحصائيًا ليس بالضرورة فرقًا مهمًا تجاريًا. قد تحصل على فرق واضح الدلالة عند عينة ضخمة جدًا، لكن قيمته صغيرة لا تغطي كلفة التنفيذ أو التعقيد الذي يضيفه. اسأل عن الأثر المتوقع بالوحدات التي تهم: أرباح إضافية، أو طلبات، أو انخفاض في تكلفة خدمة العملاء. ثم قارن هذا الأثر بتكلفة التغيير ومخاطره، لا بجدوى الإحصاء وحده، لأن الإحصاء يخبرك بوجود الأثر لا بقيمته.
ابدأ من الحد الأدنى للفرق المهم عمليًا قبل حساب العينة. إذا كان الفرق الأصغر من نصف نقطة مئوية لا يستحق إطلاق التغيير، فلا معنى لتجربة مصممة لكشف فرق بعُشر نقطة مئوية وإنفاق بيانات هائلة عليه. هذا الإطار يحميك من مطاردة إشارات ضخمة لكن تافهة، ويجعل قرار النشر مرتبطًا بالأثر لا بمجرد اللون الأخضر على اللوحة. حجم الأثر هو ما يبقى بعد أن تهدأ العشوائية وتتلاشى الحماسة الأولى.
التحقق من صحة التجربة: مشكلة عدم توافق نسبة العينة
قبل الثقة في أي فرق، تحقق من أن التقسيم يعمل كما هو مخطط. مشكلة عدم توافق نسبة العينة تعني أن أعداد الزوار بين المجموعتين تختلف اختلافًا غير متوقع. إذا كان التقسيم يفترض 50% لكل مجموعة وظهر بعد آلاف الزيارات انحراف كبير ومتّسق، فالتجربة مريبة حتى لو بدت الفروق مغرية. افحص أعداد الوصول، والتسرب، والتوزيع بين الأجهزة والقنوات والمصادر، لأن الخلل قد يختبئ في تفصيل تقني صغير.
أسباب هذا الخلل عملية غالبًا: كود يوجّه فئة معينة إلى نسخة، أو إعادة توجيه تسبب فقدانًا غير متساو، أو زيارات آلية، أو فلترة استبعدت مجموعة دون الأخرى. عند اكتشاف خلل في التقسيم، لا تصحّح النتيجة إحصائيًا، بل أصلح التنفيذ وأعد التجربة. أي حكم مبني على عيّنة ذات توزيع معوّج قد يكون قياسًا لعيوب الجمع لا لأثر التغيير نفسه، فيقودك إلى قرار خاطئ بثقة زائفة.
تأثير الحداثة والموسمية والمتغيرات الخارجية
تأثير الحداثة يظهر عندما يتفاعل المستخدم مع التغيير بحماس مؤقت لمجرد أنه جديد. قد يرتفع معدل النقر في الأيام الأولى ثم يعود إلى مستواه، فتبدو النسخة الجديدة فائزة في وقت مبكر. المقابل هو تأثير الأولوية، حيث يتشبّث المستخدم القديم بالتصميم المألوف فيرفض الجديد مؤقتًا. كلاهما ذبذبة زمنية لا حكم نهائي، ولذلك تُقرأ المنحنيات الزمنية واتجاهها لا المتوسط الواحد الذي يخفي هذا التحول.
تُضاف إلى ذلك العوامل الخارجية: عطلة، أو حملة تسويقية متزامنة، أو انقطاع خدمة، أو تغير في الأسعار. أفضل حماية أن تشغّل النسختين في الفترة نفسها بالضبط، فالتقلبات تصيب المجموعتين معًا وتبقى المقارنة عادلة. تجنّب المقارنة بطريقة قبل وبعد؛ فالتغير الزمني يختلط بتغير التصميم ولا يمكن فصلهما. وإن اضطررت إلى توزيع المدة، فتأكد أن كل مجموعة حصلت على مزيج مشابه من أيام الأسبوع وقنوات الزيارة.
الفئات الفرعية ومفارقة سيمبسون: متى تتحول القراءة إلى فخ؟
قد يبدو الاتجاه العام لصالح نسخة معينة، ثم ينقلب داخل كل فئة فرعية. هذه هي مفارقة سيمبسون: العلاقة في كل مجموعة معاكسة للعلاقة عند دمجها، بسبب اختلاف حصص الفئات بين المجموعتين. المثال الكلاسيكي هو اختلاف معدلات التحويل عندما تكون إحدى المجموعتين محمّلة بمزيج أثقل من نوع زيارات ضعيفة الأداء، فيخدع المتوسط الإجمالي القارئ ويوحي بأفضلية غير موجودة في أي فئة على حدة.
احذر مع ذلك من مطاردة الفئات الفرعية: تقطيع البيانات إلى عشرات المجموعات ينتج فروقًا وهمية بالضرورة. القاعدة العملية أن تحدّد الفئات المهمة مسبقًا على أساس تجاري واضح، لا أن تختار الفئة الفائزة بعد رؤية النتائج. تعامل مع أي اكتشاف في فئة فرعية كفرضية تحتاج تجربة جديدة، لا كحقيقة جاهزة للتنفيذ، خصوصًا حين يتعارض الاتجاه الفرعي مع الاتجاه العام أو مع منطق المنتج.
قائمة تحقق عملية قبل الإطلاق وبعده
قبل الإطلاق اتفق على مؤشر أساسي واحد، واحسب حجم العينة أو المدة من الحد الأدنى للفرق المهم، وحدّد شرط توقف مكتوبًا. جهّز فحصًا لعدم توافق نسبة العينة قبل قراءة أي نتيجة، وسجّل نسخة الإعدادات والتوزيع. تأكد أن العشوائية على مستوى المستخدم، وأن الأدوات تُطلق الأحداث بشكل متساوٍ، وأن الفلترة تطبَّق على المجموعتين بالقاعدة نفسها. هذه الخطوات البسيطة تمنع معظم النتائج المضللة قبل أن تبدأ أصلًا.
بعد الانتهاء، لا تغيّر التصميم أثناء التشغيل حتى لا تفسد المقارنة. اقرأ الفواصل بجانب المعدلات الخام، وقارن الفرق بالحد الأدنى المهم لا بالصفر فقط، وافحص التقسيم والفئات الرئيسية، ووثّق النتيجة حتى إن كانت سلبية لأنها توفّر جهدًا مستقبليًا. إن بدا الأثر واعدًا، كرّر التجربة أو اختبره في سياق آخر قبل التوسع. الفصل بين الفرق الحقيقي والصدفة ليس مهارة إحصائية فقط، بل انضباط في العملية والقرار.
أسئلة شائعة
كيف أعرف أن الفرق كبير بما يكفي لأنشره؟
قارن الفرق بالحد الأدنى المهم عمليًا الذي حددته قبل التجربة، لا بمجرد كونه معنويًا إحصائيًا. افحص فاصل الثقة لترى أقل قيمة معقولة للربح وأعلاها، ثم احسب الأثر بالوحدات التجارية واطرح منه كلفة التنفيذ والتعقيد. إذا كان الفاصل ضيقًا حول فرق يتجاوز حدك العملي، فالنشر قرار سليم. أما إن كان يمتد إلى قيم قريبة من الصفر أو سالبة، فالأفضل جمع بيانات أكثر أو إعادة التجربة بدل التسرع.
ظهر الفرق بوضوح ثم اختفى بعد أيام. ماذا حدث؟
هذا نمط شائع ينتج عن قراءة النتيجة مبكرًا تحت تأثير النظر المتكرر، أو عن تأثير الحداثة الذي يرفع التفاعل مؤقتًا ثم يهبط. قد يكون الفرق الأول مجرد ذروة عشوائية أو حماسة تجاه الجديد، لا تغيّرًا مستقرًا. القاعدة أن تحترم المدة أو حجم العينة المخططين مسبقًا، وتراقب المنحنى الزمني لا الرقم اللحظي. إن استمر التراجع، أعد التجربة بفترة أطول وحلّل الفئات لتتأكد إن كان الأثر محصورًا في شريحة واحدة.
هل يمكنني إيقاف التجربة مبكرًا إذا كانت النتيجة قوية جدًا؟
نعم، لكن فقط ضمن إطار متسلسل مصمم مسبقًا يحدد حدودًا للتوقف عند مستويات ثقة متدرجة، لا بقرار لحظي عند قفزة. التوقف العشوائي عند أول نتيجة معنوية يضخّم معدل الخطأ الإيجابي الكاذب ويجعلك تعلن فائزًا وهميًا. إن كنت تحتاج قرارًا أسرع، خطط لحدود التوقف قبل الإطلاق واحسب أثرها على مستوى الخطأ. وبدون هذا التخطيط، الالتزام بالمدة المتفق عليها هو الخيار الآمن.
ما الفرق بين التحليل على مستوى الجلسة والمستخدم؟
تحليل الجلسة يعامل كل زيارة كحالة مستقلة، وهنا يكمن الخطر لأن المستخدم نفسه قد يزور مرات عدة فيُحسب أكثر من مرة داخل المجموعة نفسها، فتتضخم العينة صناعيًا وتضيق فواصل الثقة بلا مبرر. المستخدم هو وحدة التوزيع الصحيحة في معظم تجارب المنتج، لأن العشوائية تُطبَّق عليه مرة واحدة وتبقى تجربته متسقة عبر زياراته. استخدم الجلسة فقط عندما يكون الهدف سلوكًا لحظيًا واضحًا، ووثّق اختيارك.





شارك في تقييم ونقاش المقال
رأيك يضيف قيمة للمقال ويساعدنا على تحسين المحتوى والنقاش حوله.
النقاش
جارٍ تحميل التعليقات…